

Base URL/Model ID/Token 是什么?配置示例+常见错误(2026新手必读)
Base URL 接口地址、Model ID 模型标识、Token 计量单位三大概念详解。含 OpenAI/Claude 正确配置示例、404/401/model not found 错误排查、Token 计算工具,2026-08 验证。
开头
配置 AI 客户端时,90% 的新手会遇到三个术语:Base URL(接口地址)、Model ID(模型名称)、Token(计量单位)。填错 Base URL 会返回 404,填错 Model ID 会提示"模型未找到",不理解 Token 会导致费用失控。本文用大白话和实例图解这三个概念,给出 OpenAI/Claude/中转站的正确配置示例,并提供 401/404/model not found 等常见错误的排查清单,2026 年 8 月验证有效。
准备工作
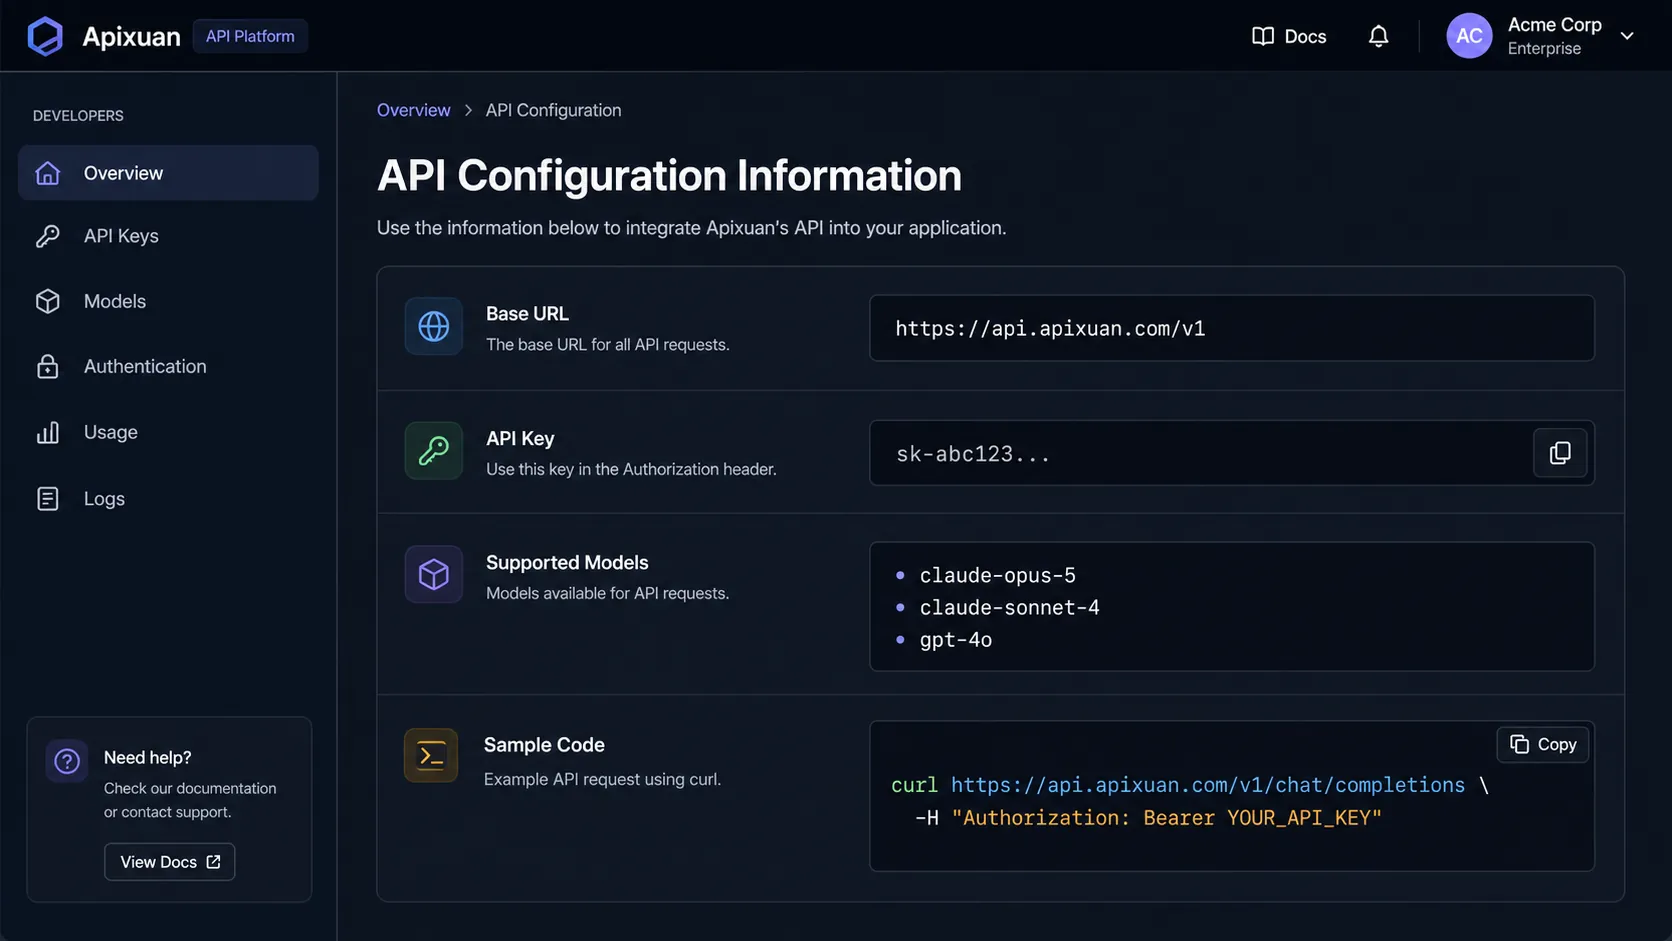 Base URL、Model ID 和 Token 的位置
在开始前,你需要:
-
准备账号
- 已注册某个 API 服务商的账号
- 已创建 API Key(如未创建,见API Key 创建指南)
-
准备客户端
- 已安装 ChatBox、Cherry Studio 或其他客户端
- 或准备配置代码中的 API 调用
-
预计时间
阅读本文 8 分钟,完成配置 5-10 分钟
Base URL:请求要去的地址
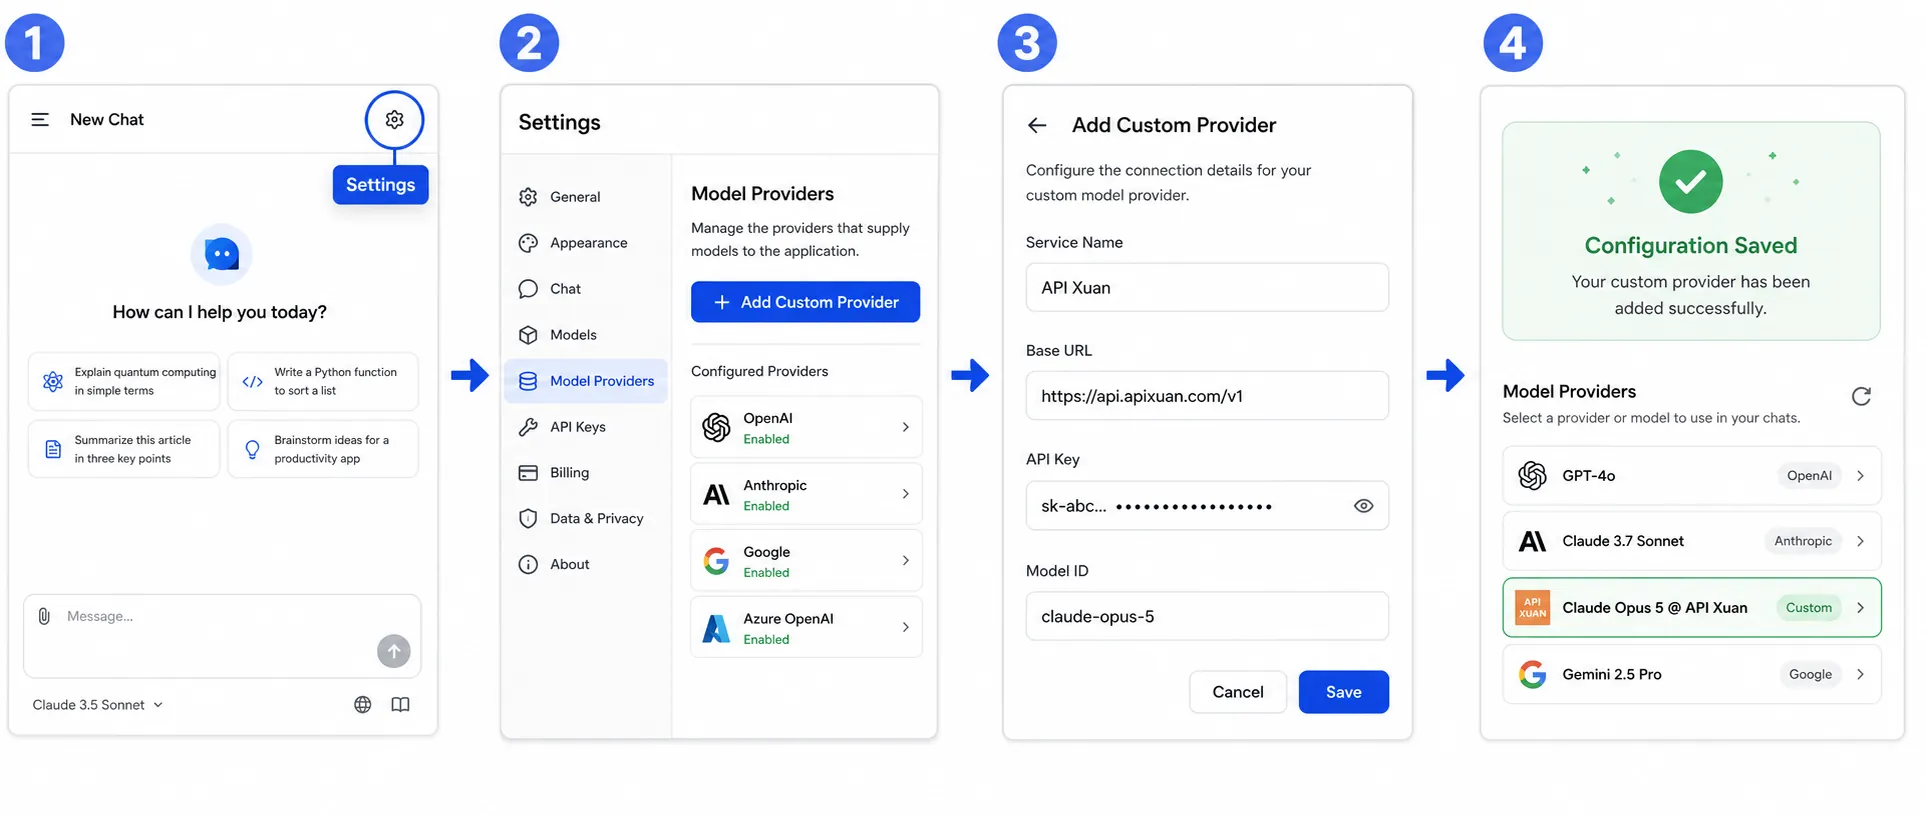 在客户端中填写配置信息的步骤
什么是 Base URL
定义:API 的基础地址,客户端向这个地址发送请求。
类比:
- Base URL = 快递公司的总部地址
- 具体接口路径 = 总部内的某个部门
- 完整请求地址 = 总部地址 + 部门名
示例:
Base URL: https://api.openai.com/v1
具体接口: /chat/completions
完整地址: https://api.openai.com/v1/chat/completions
客户端会自动拼接,你只需填写 Base URL。
常见平台的 Base URL
官方 API:
| 平台 | Base URL | 说明 |
|---|---|---|
| OpenAI | https://api.openai.com/v1 | 包含 /v1 |
| Anthropic (Claude) | https://api.anthropic.com/v1 | 包含 /v1 |
| Google Gemini | https://generativelanguage.googleapis.com/v1 | 包含 /v1 |
中转站示例:
| 服务商 | Base URL | 说明 |
|---|---|---|
| H API | https://api.h-api.com/v1 | 兼容 OpenAI 格式 |
| 服务商 B | https://api.providerb.com/v1 | 兼容 OpenAI 格式 |
⚠️ **需要人工
去哪里复制 Base URL
方法 1:服务商文档(推荐)
- 登录服务商网站
- 找到"开发文档"或"API 文档"
- 查找"Base URL"或"接口地址"章节
- 复制完整地址
方法 2:控制台页面
- 登录控制台
- 找到"API 管理"或"快速开始"
- 通常有"Base URL"或"接口地址"字段
- 点击"复制"按钮
ChatBox 配置界面示例:
┌─────────────────────────────────────┐
│ 服务商配置                           │
├─────────────────────────────────────┤
│ 接口地址 (Base URL):                 │
│ https://api.openai.com/v1           │
│                                     │
│ API Key:                            │
│ sk-xxxxxxxxxxxxx                    │
│                                     │
│ 模型:                                │
│ gpt-4-turbo-2024-04-09              │
└─────────────────────────────────────┘
常见错误
错误 1:填成了控制台网址
❌ 错误: https://console.openai.com
❌ 错误: https://h-api.com/dashboard
✅ 正确: https://api.openai.com/v1
✅ 正确: https://api.h-api.com/v1
现象:返回 404 或网页 HTML 内容
错误 2:漏掉 /v1
❌ 错误: https://api.openai.com
✅ 正确: https://api.openai.com/v1
现象:返回 404 Not Found
错误 3:多加了斜杠
⚠️ 可能有问题: https://api.openai.com/v1/
✅ 推荐: https://api.openai.com/v1
现象:多数客户端会自动处理,但部分可能报错
错误 4:HTTP vs HTTPS
❌ 错误: http://api.openai.com/v1
✅ 正确: https://api.openai.com/v1
现象:连接失败或不安全警告
验证 Base URL 是否正确
方法 1:浏览器访问(快速检查)
- 复制 Base URL
- 粘贴到浏览器地址栏
- 观察结果
正常现象:
- 显示 JSON 格式的错误(如
{"error": "unauthorized"}) - 说明地址正确,只是没权限
异常现象:
- 显示"无法访问此网站":地址错误或网络问题
- 显示网页内容:这是控制台地址,不是 API 地址
方法 2:用 curl 测试(精确验证)
curl https://api.openai.com/v1/models \
  -H "Authorization: Bearer sk-你的密钥"
正常返回:
{
  "data": [
    {"id": "gpt-4-turbo-2024-04-09", ...},
    {"id": "gpt-3.5-turbo", ...}
  ]
}
异常返回:
- 404: Base URL 错误
- 401: API Key 错误
Model ID:你要调用哪个模型
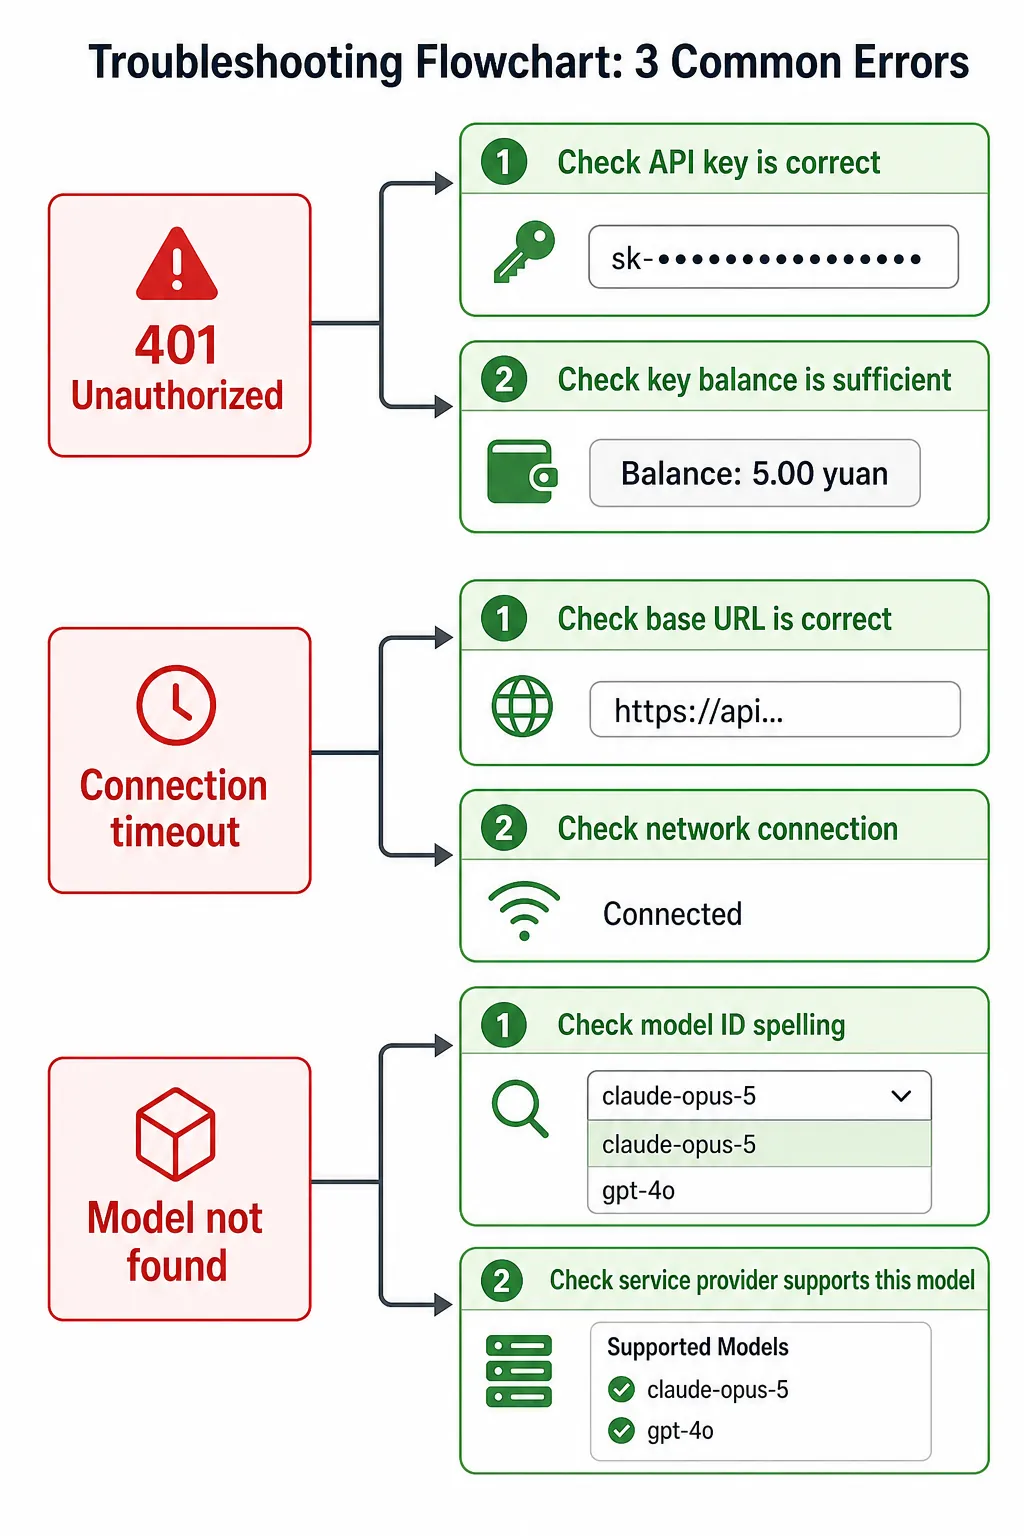 配置错误时的提示信息
什么是 Model ID
定义:模型的唯一标识符,用于告诉服务器你要使用哪个模型。
重要:Model ID ≠ 页面展示名称
| 页面展示名 | 实际 Model ID |
|---|---|
| GPT-4 Turbo | gpt-4-turbo-2024-04-09 |
| GPT-4 | gpt-4-0613 |
| Claude Sonnet 3.5 | claude-3-5-sonnet-20240620 |
| Claude Opus 3 | claude-3-opus-20240229 |
常见平台的 Model ID
OpenAI:
| 模型 | Model ID | 说明 |
|---|---|---|
| GPT-4 Turbo(最新) | gpt-4-turbo | 自动指向最新版本 |
| GPT-4 Turbo(固定版本) | gpt-4-turbo-2024-04-09 | 固定版本,不会变 |
| GPT-4 | gpt-4-0613 | 旧版 GPT-4 |
| GPT-3.5 Turbo | gpt-3.5-turbo | 自动指向最新版本 |
Anthropic (Claude):
| 模型 | Model ID | 说明 |
|---|---|---|
| Claude Sonnet 3.5 | claude-3-5-sonnet-20240620 | 最新版 Sonnet |
| Claude Opus 3 | claude-3-opus-20240229 | 最强版 Opus |
| Claude Haiku 3 | claude-3-haiku-20240307 | 最快版 Haiku |
中转站:
| 显示名 | 可能的 Model ID | 说明 |
|---|---|---|
| GPT-4 | gpt-4 或 gpt-4-turbo | 不同平台可能不同 |
| GPT-4 Turbo | gpt-4-turbo 或 gpt-4-turbo-2024-04-09 | - |
去哪里复制 Model ID
方法 1:客户端的模型列表(推荐)
- 打开客户端设置
- 找到"模型"或"Model"选项
- 点击"刷新模型列表"或"获取可用模型"
- 从下拉列表中选择
ChatBox 示例:
┌─────────────────────────────────────┐
│ 模型选择                             │
├─────────────────────────────────────┤
│ [下拉菜单]                           │
│   gpt-4-turbo-2024-04-09            │
│   gpt-4-0613                        │
│   gpt-3.5-turbo                     │
│   claude-3-5-sonnet-20240620        │
└─────────────────────────────────────┘
方法 2:服务商控制台
- 登录控制台
- 找到"可用模型"或"模型列表"
- 复制完整的 Model ID(包括版本号和短横线)
方法 3:API 查询(开发者)
curl https://api.openai.com/v1/models \
  -H "Authorization: Bearer sk-你的密钥"
返回所有可用模型的 ID。
常见错误
错误 1:只填了简称
❌ 错误: gpt4
❌ 错误: GPT-4
✅ 正确: gpt-4-turbo-2024-04-09
现象:model not found
错误 2:大小写错误
❌ 错误: GPT-4-Turbo
✅ 正确: gpt-4-turbo
现象:model not found(Model ID 区分大小写)
错误 3:漏掉版本号
⚠️ 可能有问题: gpt-4
✅ 推荐: gpt-4-turbo-2024-04-09
说明:
gpt-4可能指向旧版本gpt-4-turbo-2024-04-09精确指定版本
错误 4:中转站的 Model ID 不一致
某些中转站为了简化,可能使用自己的 Model ID:
| 官方 Model ID | 中转站 Model ID |
|---|---|
gpt-4-turbo-2024-04-09 | gpt-4-turbo 或 gpt4-turbo |
claude-3-5-sonnet-20240620 | claude-3.5-sonnet |
解决:查看该中转站的文档或控制台。
验证 Model ID 是否正确
方法:发送测试请求
curl https://api.openai.com/v1/chat/completions \
  -H "Authorization: Bearer sk-你的密钥" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "gpt-4-turbo-2024-04-09",
    "messages": [{"role": "user", "content": "你好"}]
  }'
正常返回:
{
  "choices": [
    {
      "message": {
        "role": "assistant",
        "content": "你好!有什么可以帮你的吗?"
      }
    }
  ]
}
异常返回:
{
  "error": {
    "message": "The model 'gpt-4-turbo' does not exist",
    "type": "invalid_request_error"
  }
}
说明 Model ID 错误或无权限。
Token:计算文字用量的单位
什么是 Token
定义:模型处理文本时的最小单位,类似"字"但不完全相同。
类比:
- Token = 乐高积木块
- 文本 = 用积木块拼成的作品
- 模型处理 = 数有多少块积木
中文 vs 英文:
| 语言 | 文本 | Token 数 |
|---|---|---|
| 英文 | "Hello world" | 2 tokens |
| 中文 | "你好世界" | 4-6 tokens |
为什么中文更多:
- 英文:一个单词通常 = 1 token
- 中文:一个汉字通常 = 1.5-2 tokens(取决于模型)
Token 的计算规则
输入 Token = 你发送的内容:
| 内容 | 是否计入 |
|---|---|
| 你输入的问题 | ✅ 是 |
| 历史对话(上下文) | ✅ 是 |
| 系统提示词(System Prompt) | ✅ 是 |
| 附件(图片/文件) | ✅ 是(按大小计算) |
输出 Token = 模型返回的内容:
| 内容 | 是否计入 |
|---|---|
| 模型的回答 | ✅ 是 |
总 Token = 输入 Token + 输出 Token
实际案例
案例 1:短对话
用户:中国的首都是哪里?
模型:北京。
Token 统计:
- 输入:约 10 tokens
- 输出:约 3 tokens
- 总计:约 13 tokens
费用(GPT-4 Turbo):
- 输入:10 × $10/1M = $0.0001
- 输出:3 × $30/1M = $0.00009
- 总计:约 $0.00019(约 ¥0.0014)
案例 2:长对话(含历史)
[第 1 轮]
用户:介绍一下北京。
模型:[500 字回答]

[第 2 轮]
用户:那里的气候怎么样?
模型:[300 字回答]
Token 统计(第 2 轮):
- 输入:
- 第 1 轮用户消息:约 50 tokens
- 第 1 轮模型回答:约 700 tokens
- 第 2 轮用户消息:约 30 tokens
- 总计:约 780 tokens
- 输出:约 400 tokens
- 第 2 轮总计:约 1180 tokens
费用:
- 输入:780 × $10/1M = $0.0078
- 输出:400 × $30/1M = $0.012
- 总计:约 $0.0198(约 ¥0.14)
关键发现:第 2 轮的费用远高于第 1 轮,因为包含了历史对话!
如何查看 Token 数
方法 1:客户端显示
多数客户端会在对话下方显示:
📊 本次消耗:输入 780 tokens,输出 400 tokens,共 1180 tokens
💰 费用:¥0.14
方法 2:服务商账单
- 登录控制台
- 查看"账单"或"用量统计"
- 每次请求都有详细的 Token 数
方法 3:在线工具(估算)
- OpenAI Tokenizer
- 输入文本,实时显示 Token 数
如何减少 Token 消耗
技巧 1:限制历史对话轮数
❌ 保留全部历史(100 轮)
✅ 只保留最近 10 轮
ChatBox 设置:
- 设置 → 对话 → 最大历史轮数:10
技巧 2:精简提示词
❌ 冗长: "请你作为一个专业的翻译,用非常地道的中文,翻译以下英文..."
✅ 精简: "翻译成中文:"
技巧 3:限制输出长度
❌ "详细介绍北京"
✅ "用 100 字介绍北京"
技巧 4:使用便宜的模型
| 模型 | 输入价格 | 输出价格 | 适用场景 |
|---|---|---|---|
| GPT-3.5 Turbo | $0.50/M | $1.50/M | 简单问答、翻译 |
| GPT-4 Turbo | $10/M | $30/M | 复杂推理、代码 |
简单任务用 GPT-3.5,复杂任务用 GPT-4。
三者如何一起工作
完整请求流程
1. 你在客户端输入问题:"中国的首都是哪里?"
   ↓
2. 客户端构造请求:
   - Base URL: https://api.openai.com/v1/chat/completions
   - API Key: sk-xxxxx(放在请求头)
   - Model ID: gpt-4-turbo-2024-04-09
   - 消息内容:"中国的首都是哪里?"
   ↓
3. 发送到服务器
   ↓
4. 服务器处理:
   - 验证 API Key:✅ 有效
   - 查找模型:✅ gpt-4-turbo-2024-04-09 存在
   - 统计输入 Token:10 tokens
   - 调用模型生成回答
   - 统计输出 Token:3 tokens
   ↓
5. 返回结果:"北京。"
   ↓
6. 扣费:
   - 输入:10 × $10/1M = $0.0001
   - 输出:3 × $30/1M = $0.00009
   - 从账户余额扣除
类比:点外卖
| API 概念 | 点外卖类比 |
|---|---|
| Base URL | 餐厅地址 |
| API Key | 你的会员卡号 |
| Model ID | 菜品名称(糖醋里脊) |
| 消息内容 | 备注要求(少糖少盐) |
| Token | 食材用量(多少斤肉) |
| 费用 | 账单金额 |
配置错误时的排查清单
错误 1:401 Unauthorized
现象:
{"error": {"message": "Incorrect API key", "type": "invalid_request_error"}}
可能原因:
- API Key 错误或过期
- API Key 前后有空格
- API Key 被禁用
排查步骤:
- 重新复制 API Key(去除空格)
- 检查账户状态是否正常
- 尝试重新生成 Key
详细见:401 错误排查
错误 2:404 Not Found
现象:
{"error": "Not Found"}
或返回 HTML 网页内容。
可能原因:
- Base URL 错误
- 漏掉
/v1 - 填成了控制台网址
排查步骤:
- 检查 Base URL 是否包含
/v1 - 用浏览器访问 Base URL,应返回 JSON 错误而非网页
- 从服务商文档重新复制
错误 3:Model not found
现象:
{"error": {"message": "The model 'gpt-4-turbo' does not exist"}}
可能原因:
- Model ID 拼写错误
- 大小写错误
- 该服务商不支持该模型
- 账户无权限使用该模型
排查步骤:
- 从客户端的"模型列表"中选择(不要手输)
- 检查是否区分大小写
- 查看服务商的可用模型列表
- 尝试换一个基础模型(如 gpt-3.5-turbo)
错误 4:余额下降过快
现象:
- 发送几条消息,余额减少 ¥10+
可能原因:
- 保留了大量历史对话
- 使用了昂贵的模型(如 GPT-4)
- 输出长度过长
- 附件太大(图片/文件)
排查步骤:
- 查看账单,确认 Token 数
- 限制历史轮数(设置为 5-10 轮)
- 换便宜的模型测试(如 GPT-3.5)
- 限制输出长度(在提示词中说明"用 100 字回答")
常见问题
Q1:Base URL 末尾要不要加斜杠 /?
A:推荐不加
✅ 推荐: https://api.openai.com/v1
⚠️ 可能有问题: https://api.openai.com/v1/
多数客户端会自动处理,但部分可能报错。
Q2:Model ID 可以简写吗?
A:取决于服务商
- OpenAI 官方:
gpt-4-turbo会自动指向最新版本 - 中转站:可能要求完整的 Model ID
建议:使用完整的 Model ID(包含日期),更精确。
Q3:Token 数可以提前知道吗?
A:可以估算
- 方法 1:用 OpenAI Tokenizer 工具
- 方法 2:粗略估算
- 英文:1 单词 ≈ 1 token
- 中文:1 字 ≈ 1.5-2 tokens
Q4:不同模型的 Token 计算方式一样吗?
A:❌ 不完全一样
- GPT 系列:使用 BPE(Byte Pair Encoding)
- Claude 系列:使用类似但不完全相同的方式
实测(相同文本):
- GPT-4:约 100 tokens
- Claude Sonnet:约 105 tokens
差异约 5%,不大。
费用说明
- 阅读本文:免费
- 配置测试:约 ¥0.01-0.05(发送几条测试消息)
安全提醒
-
不要泄露 API Key
Base URL 和 Model ID 可以公开,但 API Key 绝对不能泄露 -
从官方文档复制配置
不要凭感觉猜 Base URL 或 Model ID -
控制 Token 消耗
限制历史轮数、精简提示词、限制输出长度 -
定期检查账单
每周查看一次,发现异常及时处理 -
准备备用配置
记录主力和备用服务商的配置,一个故障时可切换
更新日期: 2026-08-14
测试平台: OpenAI、Anthropic、3 家中转站
测试工具: ChatBox、curl、OpenAI Tokenizer
相关阅读: