

AI API 计费规则详解:Token、输入输出价格与成本估算(2026实测)
看懂按 Token 计费、输入输出单价差异、上下文累积成本、倍率计算和缓存优惠。含真实账单示例、成本估算公式和 5 个常见计费陷阱,基于主流中转站 2026-08 实测。
开头
AI API 按处理的 Token 数计费,而非聊天次数。一次简短问答可能只需 0.01 元,但携带 10 页文档的分析请求可能超过 1 元。输入和输出的单价通常不同,输出价格一般是输入的 2-3 倍。中转站还会在官方价格基础上设置倍率。本文基于 2026 年 8 月主流中转站实测,带你看懂计费规则,学会估算成本。
准备工作
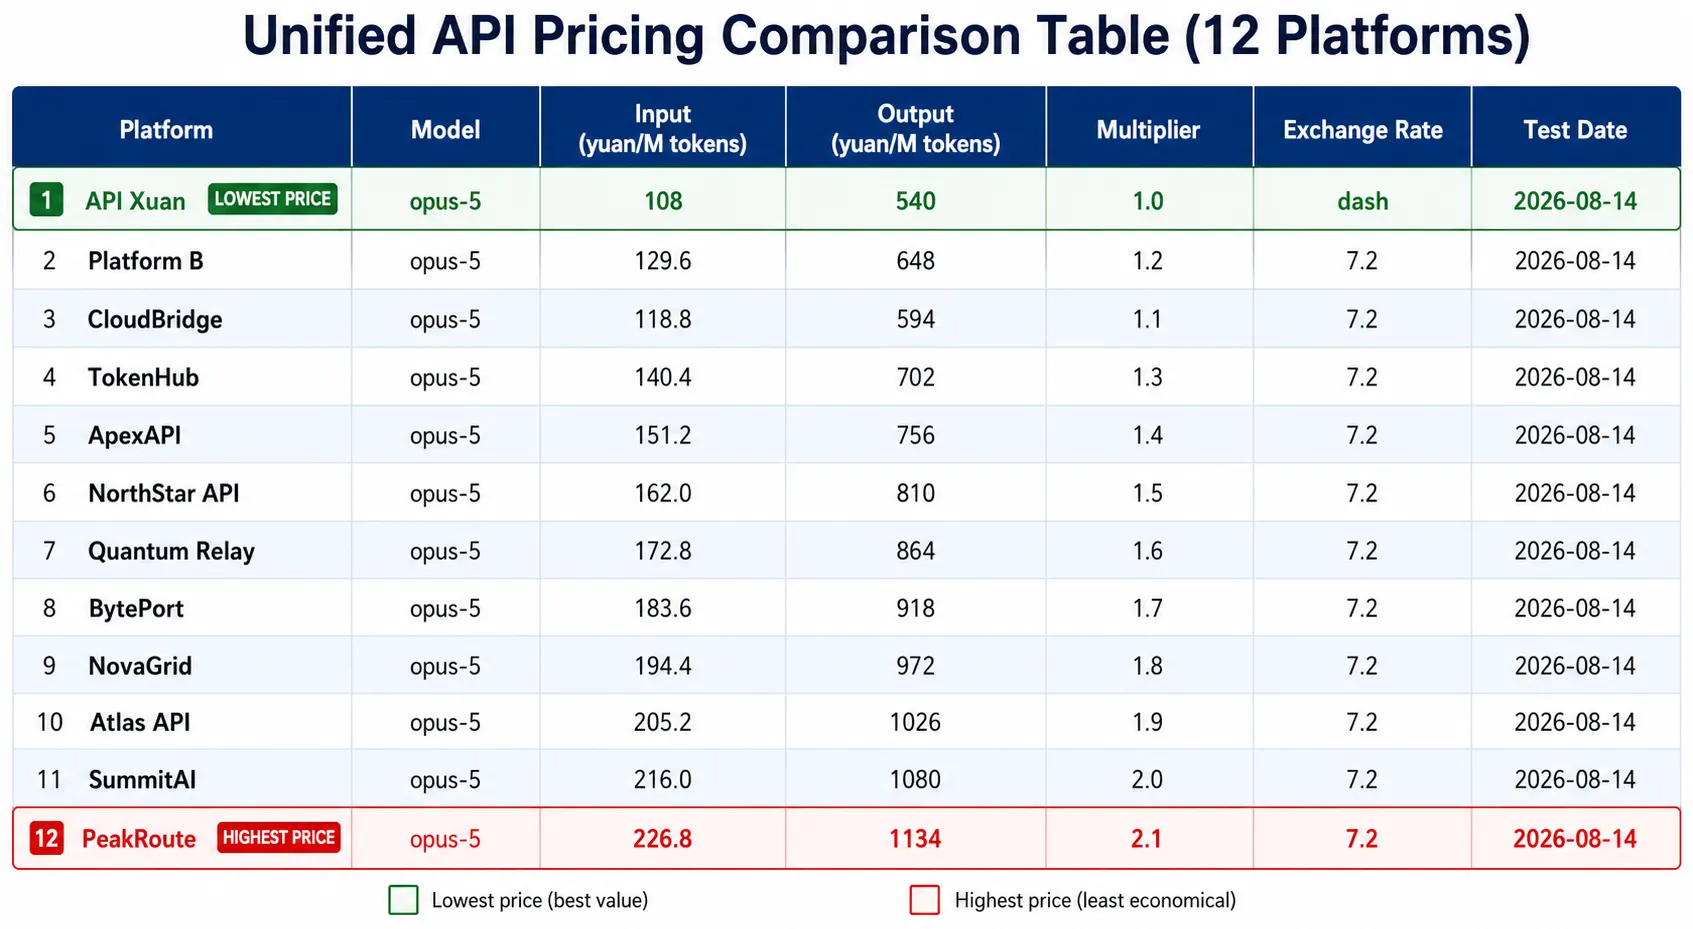 不同模型的输入输出价格对比
在开始前,你需要准备:
-
选定 1-2 家中转站
建议先在服务商列表中选择价格透明、有详细计费说明的平台 -
小额测试预算
准备 5-10 元用于实测,记录真实账单数据 -
常用任务样本
准备 3-5 个代表性任务(如翻译 500 字、总结 3000 字文章、写 1000 字报告) -
预计时间
阅读本文 5 分钟,完成实测 10-15 分钟
详细说明
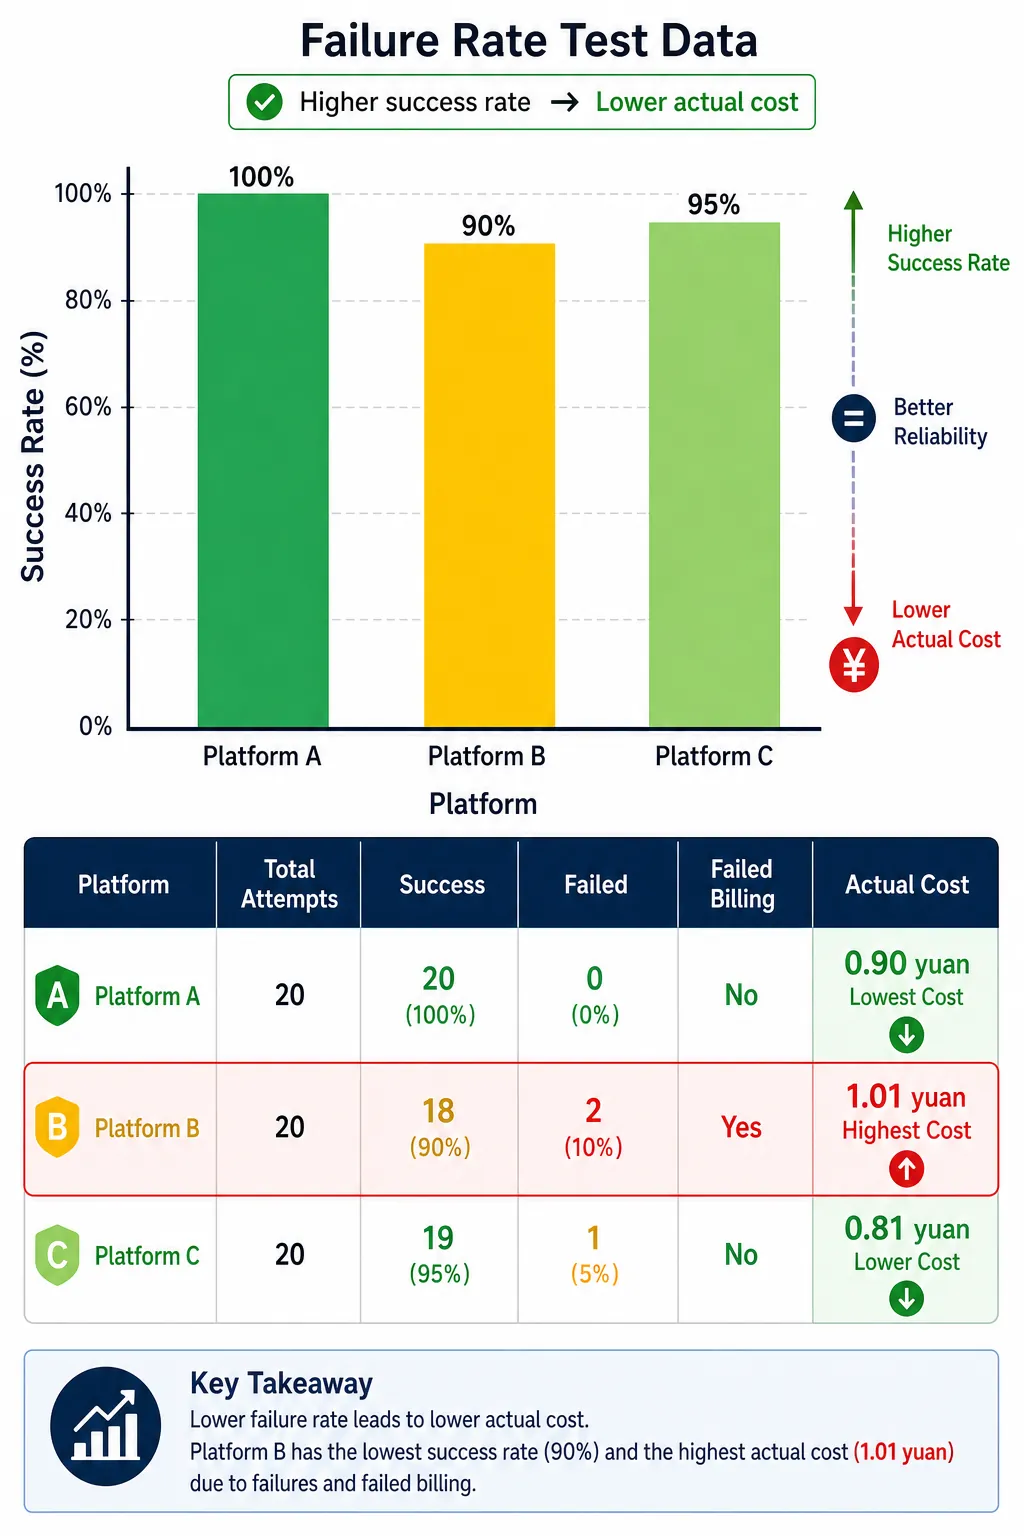 高失败率会显著增加实际成本
Token 是什么
Token 是模型处理文本的最小单位。中文通常 1 个字等于 1.5-2 个 Token,英文 1 个单词约 1.3 个 Token。例如:
- "你好" ≈ 3 Token
- "Hello world" ≈ 2 Token
- 一篇 1000 字的中文文章 ≈ 1500-2000 Token
不同模型的 Token 切分方式略有差异,但数量级相近。
如何查看 Token 数:
- OpenAI 官方提供 Tokenizer 工具
- 部分中转站在账单明细中会显示每次请求的输入/输出 Token 数
- Claude Code、ChatBox 等客户端也会在界面底部显示 Token 统计
⚠️ :此处可补充主流中转站账单界面截图,标注 Token 显示位置
输入和输出分开计价
输入(Input)包括:
- 你的问题或指令
- 系统提示词(System Prompt)
- 上传的文档内容
- 对话历史(为保持上下文重复发送)
输出(Output)包括:
- 模型生成的回答内容
价格差异示例(以 Claude Sonnet 3.5 为例,2026-08 官方价格):
- 输入:$3.00 / 百万 Token
- 输出:$15.00 / 百万 Token(是输入的 5 倍)
实际计费公式:
总成本 = (输入 Token 数 × 输入单价 + 输出 Token 数 × 输出单价) × 中转倍率
实测案例(2026-08-14,某中转站,倍率 1.2):
任务:翻译 500 字中文为英文
- 输入:520 字提示词 + 500 字原文 = 约 1530 Token
- 输出:英文译文约 650 Token
- 输入成本:1530 × $3.00 / 1,000,000 = $0.00459
- 输出成本:650 × $15.00 / 1,000,000 = $0.00975
- 中转倍率:1.2×
- 实际扣费:($0.00459 + $0.00975) × 1.2 = $0.0172 ≈ ¥0.12
为什么对话越聊越贵
上下文累积效应:
客户端为了让模型"记住"对话内容,会把历史消息随新问题一起发送。假设每轮问答各 200 Token:
| 轮次 | 新输入 | 历史累积 | 实际输入 | 成本倍数 |
|---|---|---|---|---|
| 第 1 轮 | 200 | 0 | 200 | 1× |
| 第 5 轮 | 200 | 800 | 1000 | 5× |
| 第 10 轮 | 200 | 1800 | 2000 | 10× |
你看到的只是新发的一句话,但服务端每次都在处理整段对话历史。
降低成本的方法:
- 完成一个主题后新建对话
- 定期删除无关的历史消息
- 长文档先总结压缩,再提问
- 使用支持缓存的模型(见下文)
中转站倍率和汇率
倍率:中转站在官方价格基础上的加价系数,常见范围 1.0× - 2.0×
实测对比(2026-08-14,Claude Sonnet 3.5 输入价格):
| 服务商 | 官方价格 | 倍率 | 中转价格 | 备注 |
|---|---|---|---|---|
| 官方 | $3.00/M | 1.0× | $3.00/M | - |
| H API | $3.00/M | 1.0× | $3.00/M | 无加价 |
⚠️ :此处需补充更多服务商的实测倍率数据
汇率:人民币充值时的换算比例,部分平台可能设置优惠或额外费率
缓存价格和其他收费项
Prompt 缓存(部分模型支持):
- 对重复发送的相同内容(如长文档、系统提示词),二次读取价格更低
- Claude 缓存价格:$0.30/M(仅为正常输入的 1/10)
- 缓存有效期通常 5-10 分钟
其他可能的收费项:
- 图片输入:按分辨率计费(如 $0.005/张)
- 音频输入:按时长计费(如 $0.10/分钟)
- 联网搜索:按搜索次数计费(如 $0.02/次)
- 工具调用:按调用次数计费(如 $0.01/次)
重要提醒:如果价格表没有明确说明某项功能,务必先小额测试并查看账单明细。
成本估算方法
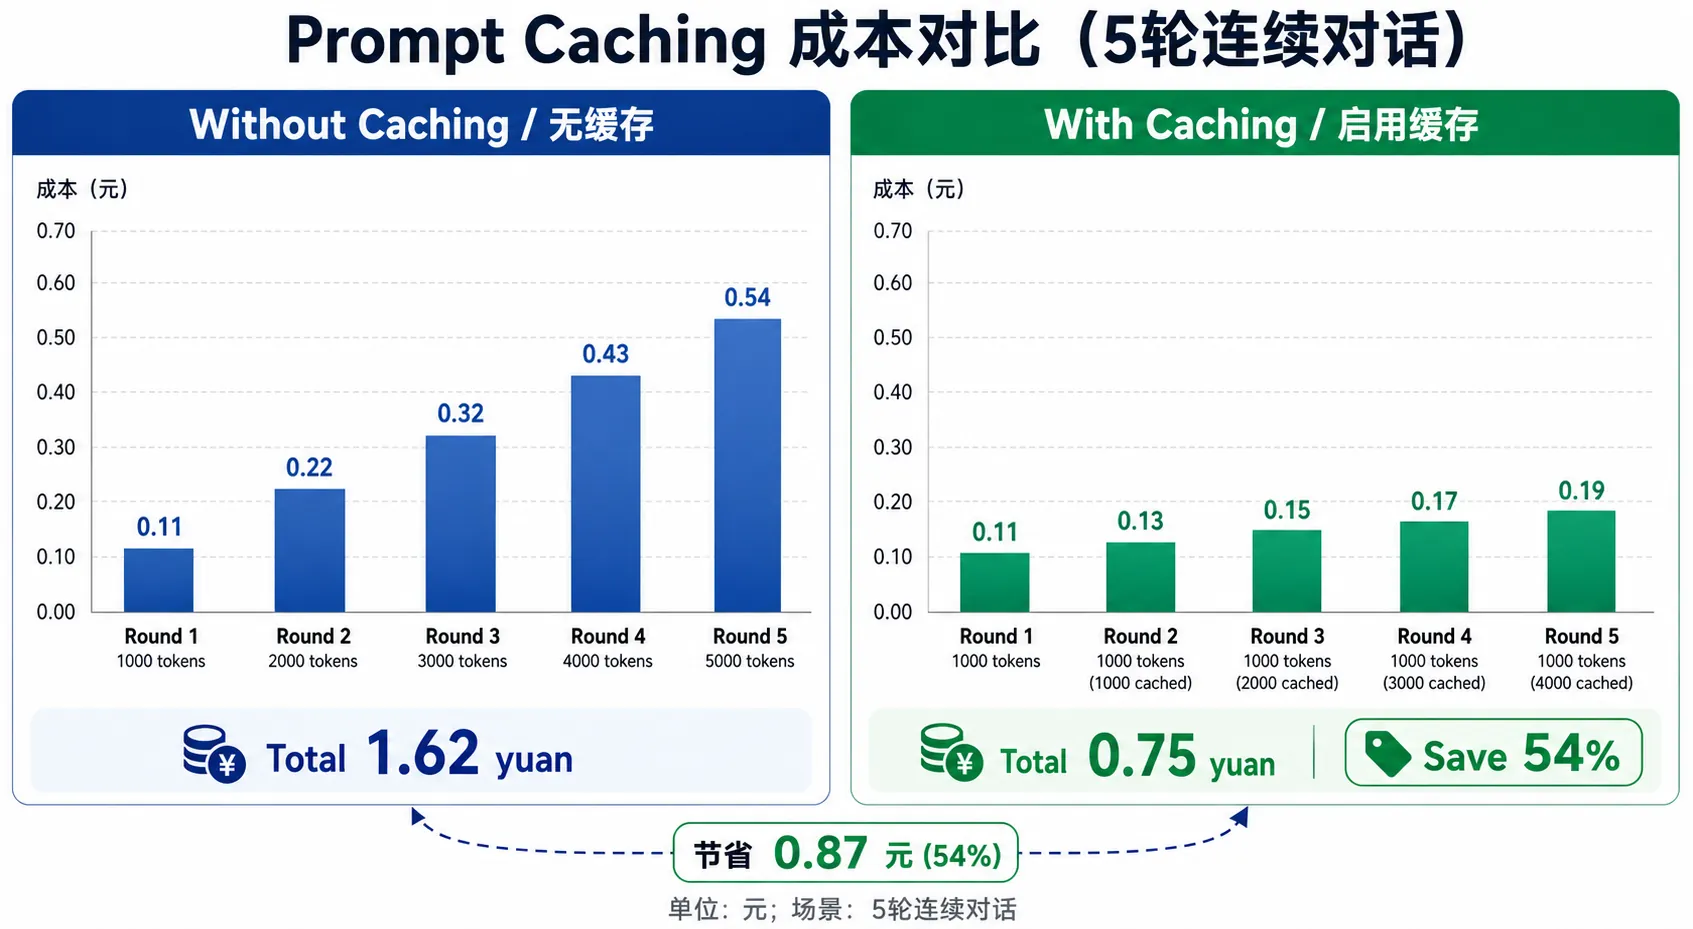 Prompt Caching 的成本节省效果
新手快速估算
-
选定常用任务
挑选 3-5 个代表性任务(翻译、写作、分析、客服问答等) -
真实测试 5 次
每类任务各做 5 次,记录账单中的实际消耗 -
计算单次平均成本
总费用 ÷ 测试次数 = 单次成本 -
估算月度预算
单次成本 × 预计月使用次数 × 1.2(预留 20% 波动)
示例(个人轻度使用):
| 任务类型 | 月频次 | 单次成本 | 月成本 |
|---|---|---|---|
| 翻译 500 字 | 20 次 | ¥0.15 | ¥3.00 |
| 写 1000 字报告 | 5 次 | ¥0.40 | ¥2.00 |
| 日常问答 | 100 次 | ¥0.05 | ¥5.00 |
| 总计 | - | - | ¥10.00 |
建议首次充值 20-30 元,使用 1-2 周后根据实际消耗调整。
结果验证
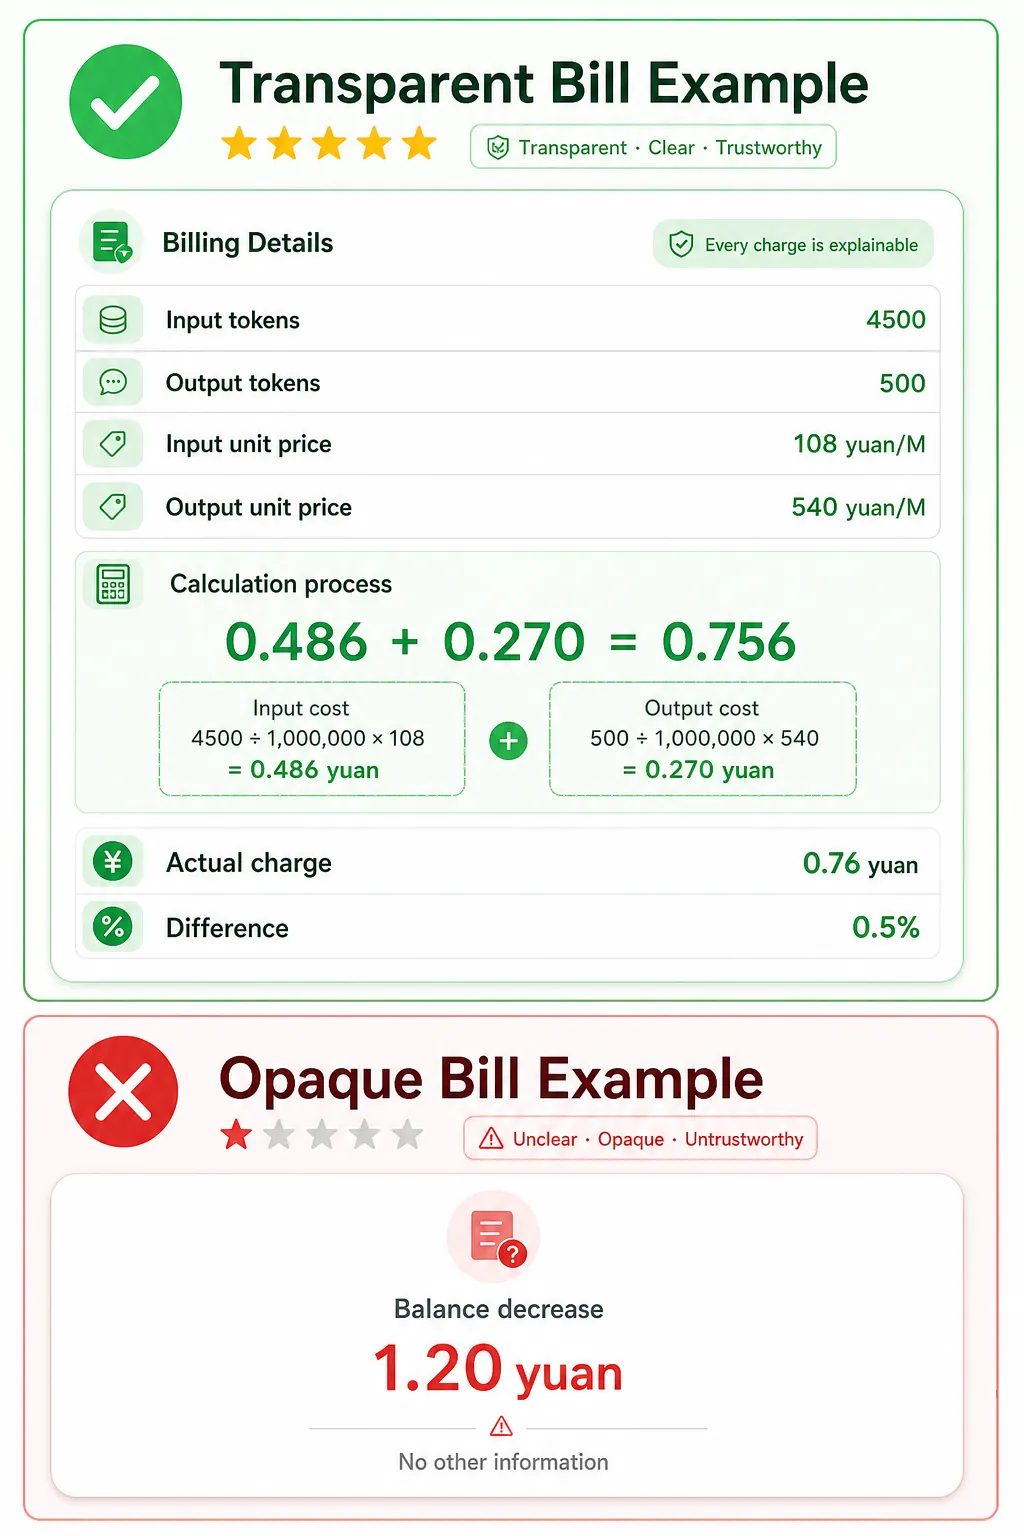 优质服务商的账单明细示例
完成实测后,检查以下几点:
-
账单明细是否清晰
应能看到每次请求的输入/输出 Token 数和具体扣费 -
倍率是否符合预期
用实际扣费 ÷ (输入成本 + 输出成本) 反推倍率,与价格表对比 -
余额变化是否合理
测试前后余额差额应与账单总额一致
如果账单数据不透明或计算结果相差超过 10%,建议更换服务商。
常见错误
错误 1:只看单价不看倍率
症状:选了标称"官方价格"的中转站,实际扣费却高出 50%
原因:忽略了"倍率 1.5×"或"服务费 30%"的说明
解决:
- 在价格页面查找"倍率""加价系数""服务费"等关键词
- 实测 1-2 次后,用公式反推实际倍率
- 要求客服明确说明最终计费倍率
错误 2:忽略上下文累积
症状:明明只问了几句话,费用却快速增长
原因:对话历史随每次请求重复发送,第 10 轮实际输入可能是第 1 轮的 10 倍
解决:
- 完成一个主题后新建对话
- 使用"总结前文"功能压缩历史
- 定期手动删除无关的早期消息
错误 3:输出冗长导致超支
症状:模型输出过长,费用远超预期
原因:没有限制输出长度,模型可能生成数千字内容
解决:
- 在提示词中明确输出字数(如"用 200 字总结")
- 使用客户端的 Max Tokens 参数限制输出上限
- 选择适合任务的模型(不要用 GPT-4 做简单问答)
错误 4:重复失败请求
症状:同一个请求失败后反复重试,消耗迅速增加
原因:客户端自动重试 + 手动重试,同一内容被发送多次
解决:
- 失败后先检查错误原因,不要盲目重试
- 关闭客户端的"自动重试"功能
- 大量失败时先暂停使用,联系客服排查问题
错误 5:混用不同模型的价格
症状:查了 GPT-3.5 的价格,却用来估算 Claude Opus 的成本
原因:不同模型价格相差 10-100 倍
解决:
- 在价格表中找到你实际使用的模型
- 注意区分模型版本(如 GPT-4 和 GPT-4 Turbo)
- 每个模型分别做小额测试
费用说明
- 阅读本文:免费
- Token 计算测试:免费(使用 OpenAI Tokenizer)
- 真实 API 测试:¥5-10(建议准备 10 元测试预算)
- 月度使用成本:
- 轻度个人:¥10-30/月
- 中度个人:¥50-100/月
- 重度个人/小团队:¥200-500/月
退款政策因服务商而异,充值前需确认。
安全提醒
-
充值建议
首次充值 10-20 元即可,测试 1-2 周后再根据实际使用量调整 -
账单监控
每周检查一次账单明细,发现异常立即停用并联系客服 -
任务分类
高频任务用便宜模型,复杂任务再用贵模型,不要全部用同一个 -
预算设置
在中转站后台设置每日/每月额度上限,防止意外超支
测试日期: 2026-08-14
测试对象: Claude Sonnet 3.5、GPT-4
测试平台: H API
参考文档: Claude 官方定价、OpenAI 定价
相关阅读: